
Hola a tod@s,
En el artículo anterior vimos cómo desplegar y servir un LLM con vLLM en un Dell Pro Max GB10. La idea era sencilla y muy útil para laboratorio o para un entorno pequeño: Linux, GPU NVIDIA, Docker, un modelo descargado desde Hugging Face y una API compatible con OpenAI.
Pero al llevar esta misma necesidad a una organización aparecen nuevas preguntas. ¿Cómo damos servicio a varios equipos? ¿Cómo evitamos que el modelo dependa de un único equipo? ¿Cómo controlamos actualizaciones, identidades, red, secretos, capacidad y observabilidad? Aquí es donde Azure Local puede convertirse en la base de una plataforma de IA ejecutada dentro de nuestro propio centro de datos.
Azure Local no sustituye al motor de inferencia. vLLM seguirá siendo quien cargue el modelo y responda a las peticiones. Lo que aporta Azure Local es la capa de infraestructura híbrida: cómputo, almacenamiento, redes, virtualización, integración con Azure Arc y una ruta hacia Kubernetes para operar el servicio con criterios empresariales.
QUÉ VAMOS A CONSEGUIR Diseñaremos dos caminos: una máquina virtual Linux con GPU para empezar de forma controlada y una plataforma con AKS habilitado por Azure Arc para escalar. El laboratorio principal se centrará en Kubernetes porque permite separar infraestructura, runtime y aplicación.
Me viene a la cabeza una pregunta que me hizo un amigo de la comunidad tecnológica.
¿Por qué ejecutar modelos de IA en local?
- Mantener prompts, documentos, código y respuestas dentro del perímetro definido por la organización.
- Reducir latencia cuando las aplicaciones y los datos ya están en el datacenter o en el Edge.
- Operar en ubicaciones con conectividad limitada o con requisitos estrictos de soberanía.
- Controlar el ciclo de vida del runtime, del modelo y de la infraestructura.
- Crear una API interna reutilizable por asistentes, automatizaciones, RAG y herramientas de desarrollo.
- Predecir el coste cuando la demanda es estable y el hardware se aprovecha de forma sostenida.
Tener el modelo en local no elimina los riesgos. Al contrario, nos convierte en responsables del parcheado, la protección del endpoint, las licencias del modelo, la gestión de secretos, el filtrado de datos y la capacidad. La soberanía no consiste solo en guardar los pesos en nuestro CPD; también implica gobernar todo el servicio.
Azure Local como base para IA privada
Podemos ver la solución en cuatro capas:
| Capa | Componentes | Responsabilidad |
| Infraestructura | Nodos Azure Local, red, almacenamiento, GPU | Disponibilidad, rendimiento y ciclo de vida del hardware. |
| Plataforma | VM Linux o AKS habilitado por Azure Arc | Aislamiento, scheduling, actualizaciones y políticas. |
| Serving (publicar un modelo de IA como servicio para que se puedan utilizar) | vLLM, imagen de contenedor, caché de modelos | Carga de pesos, KV cache, batching y API. |
| Consumo (Quien va a utilizar el modelo y como lo va a utilizar) | Aplicaciones, RAG, agentes, portales internos | Autenticación, experiencia, datos y casos de uso. |
Dos caminos de despliegue
| Opción | Cuando elegirla | Ventajas | Límites |
| VM Linux + GPU | Piloto, un modelo, pocos consumidores | Sencilla, cercana al artículo anterior, troubleshooting directo. | Escalado y alta disponibilidad más manuales. |
| AKS + GPU | Varios modelos o equipos, GitOps, necesidad de estandarización | Despliegues declarativos, servicios, rolling updates y políticas. | Más componentes, curva operativa y soporte GPU dependiente de versión. |
Mi recomendación es comenzar con una VM si todavía estamos validando el modelo y el patrón de consumo. Cuando la API pase a ser un servicio compartido, tengamos varios consumidores o necesitemos una operación repetible, Kubernetes empieza a aportarnos valor.
Arquitectura de referencia
La siguiente arquitectura nos muestra cómo podemos transformar un laboratorio basado en una única GPU en una plataforma empresarial gobernada desde Azure. Los usuarios consumen una API interna protegida por un gateway, mientras que vLLM ejecuta los modelos sobre nodos con GPU dentro de Kubernetes. Azure Arc proporciona gobierno, políticas y operaciones, mientras que Azure Local aporta la infraestructura de ejecución.
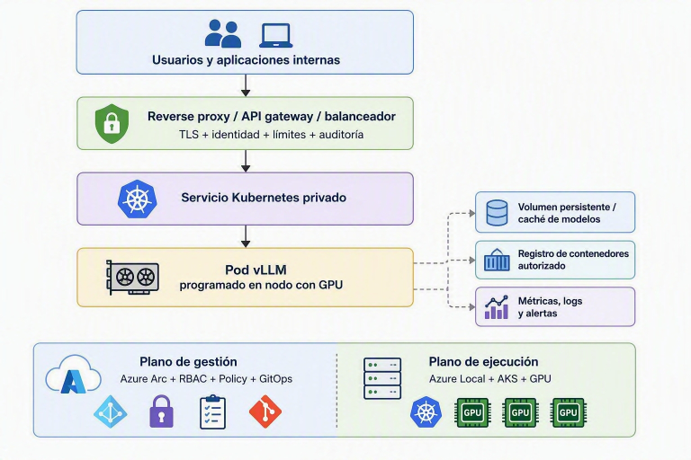
El endpoint de vLLM no debería publicarse directamente en Internet. En producción lo normal es situarlo detrás de una capa que termine TLS, autentique al cliente, aplique cuotas, limite el tamaño de las peticiones y genere trazabilidad.
Requisitos previos
- Una instancia de Azure Local instalada, registrada y saludable.
- Hardware validado para la versión desplegada, incluida la opción de GPU cuando corresponda.
- AKS habilitado por Azure Arc operativo, o una VM Linux si elegimos el camino inicial.
- Driver y device plug-in compatibles con la GPU y con la versión de Kubernetes.
- Registro de contenedores autorizado y repositorio para manifiestos.
- Almacenamiento suficiente para imagen, pesos, caché y posibles variantes del modelo.
- Conectividad controlada hacia el registro y el repositorio del modelo, o un proceso offline de importación.
- Licencia del modelo revisado y, si es necesario, credenciales de Hugging Face con permisos mínimos.
- DNS, certificados y una red privada para consumidores internos.
- Una estimación de memoria GPU que incluya pesos, KV cache, contexto y concurrencia.
DECISIÓN CRÍTICA No seleccionéis un modelo solo por su número de parámetros. La cuantización, la longitud de contexto, la la concurrencia y el runtime modifican de forma importante el consumo real de memoria.
Paso 1. Validar el clúster y localizar la GPU
Antes de desplegar vLLM comprobaremos que Kubernetes ve el recurso acelerador. Los nombres exactos de los nodos y del recurso pueden variar según el plug-in utilizado.
kubectl get nodes -o wide
kubectl describe nodes | grep -i -E «nvidia.com/gpu|gpu»
kubectl get pods -A | grep -i nvidia
El resultado esperado es que al menos un nodo publique capacidad GPU y que los componentes del device plug-in estén en estado Running. Si Kubernetes no anuncia la GPU, no merece la pena continuar con el modelo: primero debemos resolver driver, firmware, asignación y compatibilidad.
Paso 2. Preparar namespace, secretos y almacenamiento
Separaremos la carga en un namespace y así evitaremos incluir tokens directamente en el manifiesto.
kubectl create namespace ai-inference
kubectl -n ai-inference create secret generic hf-token \
–from-literal=token=»hf_REEMPLAZAR»
Para la caché del modelo necesitamos una StorageClass disponible en el clúster. El siguiente ejemplo solicitamos 200 GiB; ajustamos el tamaño del modelo y a vuestra política de almacenamiento.
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
name: hf-cache
namespace: ai-inference
spec:
accessModes:
– ReadWriteOnce
resources:
requests:
storage: 200Gi
storageClassName: REEMPLAZAR_STORAGECLASS
Paso 3. Desplegar vLLM con GPU
Este manifiesto es una base de laboratorio. Fijaremos una imagen versionada en lugar de latest, solicitaremos una GPU y montaremos la caché. Debemos sustituir el modelo, la etiqueta de imagen y los valores de capacidad por versiones validadas en nuestro entorno.
apiVersion: apps/v1
kind: Deployment
metadata:
name: vllm
namespace: ai-inference
spec:
replicas: 1
selector:
matchLabels:
app: vllm
template:
metadata:
labels:
app: vllm
spec:
containers:
– name: vllm
image: vllm/vllm-openai:REEMPLAZAR_VERSION
args:
– –model
– REEMPLAZAR_MODELO
– –max-model-len
– «8192»
– –gpu-memory-utilization
– «0.80»
env:
– name: HF_TOKEN
valueFrom:
secretKeyRef:
name: hf-token
key: token
ports:
– name: http
containerPort: 8000
resources:
requests:
cpu: «4»
memory: 24Gi
nvidia.com/gpu: «1»
limits:
cpu: «8»
memory: 48Gi
nvidia.com/gpu: «1»
readinessProbe:
httpGet:
path: /health
port: http
initialDelaySeconds: 30
periodSeconds: 10
failureThreshold: 60
volumeMounts:
– name: hf-cache
mountPath: /root/.cache/huggingface
volumes:
– name: hf-cache
persistentVolumeClaim:
claimName: hf-cache
En un clúster con nodos heterogéneos añadiremos labels, nodeSelector o affinity para que el pod solo se programe donde exista la GPU adecuada. También es habitual aplicar taints a los nodos acelerados para reservarlos a las cargas de IA.
Paso 4. Exponer el servicio dentro de la red
apiVersion: v1
kind: Service
metadata:
name: vllm
namespace: ai-inference
spec:
selector:
app: vllm
ports:
– name: http
port: 8000
targetPort: http
type: ClusterIP
ClusterIP mantiene el servicio accesible únicamente dentro de Kubernetes. Para consumidores externos al clúster utilizaremos un ingress controller, un reverse proxy o un balanceador interno con TLS y autenticación. No cambiaremos a LoadBalancer sin haber definido antes red, exposición y controles de acceso.
Paso 5. Aplicar y validar
kubectl apply -f pvc.yaml
kubectl apply -f deployment.yaml
kubectl apply -f service.yaml
kubectl -n ai-inference rollout status deployment/vllm
kubectl -n ai-inference get pods -o wide
kubectl -n ai-inference logs -f deployment/vllm
La primera carga será más lenta porque se debe descargar o leer los pesos. Esperaremos a que la readiness probe esté correcta y después haremos una prueba temporal mediante port-forward.
kubectl -n ai-inference port-forward service/vllm 8000:8000
curl http://127.0.0.1:8000/health
Paso 6. Probar la API compatible con OpenAI
curl http://127.0.0.1:8000/v1/chat/completions \
-H «Content-Type: application/json» \
-d ‘{
«model»: «REEMPLAZAR_MODELO»,
«messages»: [
{«role»: «system», «content»: «Responde en español y de forma concisa.»},
{«role»: «user», «content»: «Explica qué aporta Azure Local a una plataforma de IA privada.»}
],
«max_tokens»: 300,
«temperature»: 0.2
}’
Si obtenemos un array choices y contenido en message.content, el flujo básico funciona. Esto solo valida funcionalidad, no capacidad ni seguridad.
Paso 7. Consumirlo desde Python
from openai import OpenAI
client = OpenAI(
base_url=»https://ia.interna.ejemplo/v1″,
api_key=»token-obtenido-del-gateway»
)
respuesta = client.chat.completions.create(
model=»REEMPLAZAR_MODELO»,
messages=[
{«role»: «user», «content»: «Resume las ventajas de Azure Local.»}
],
max_tokens=300,
temperature=0.2
)
print(respuesta.choices[0].message.content)
La compatibilidad con el formato OpenAI simplifica la integración, pero no significa que todas las extensiones o comportamientos sean idénticos. Debemos probar el cliente, el modelo y el endpoint concretos.
Seguridad: lo mínimo para producción
| Control | Aplicación práctica |
| Red | Endpoint privado, segmentación, firewall y acceso solo desde redes autorizadas. |
| Identidad | Autenticación en gateway; evitar confiar en una clave de laboratorio colocada en el cliente. |
| TLS | Certificados internos o públicos según el escenario; rotación automatizada. |
| Secretos | Secretos fuera de YAML y repositorios; rotación y privilegio mínimo. |
| Imágenes | Versiones fijadas, análisis de vulnerabilidades y registro autorizado. |
| Modelos | Licencia, procedencia, hash, versionado y proceso de aprobación. |
| Datos | Clasificación, DLP, retención y prevención de prompts con información innecesaria. |
| Abuso | Cuotas, límites de tokens, tamaño máximo de prompt, timeout y límites por consumidor. |
| Auditoría | Registrar identidad, modelo, latencia, tokens y resultado técnico sin almacenar datos sensibles por defecto. |
NO OLVIDEMOS Un modelo local puede inventar información, revelar contenido presente en su contexto o producir una respuesta insegura. La ubicación del modelo no sustituye la validación de salida, el diseño responsable ni los controles de aplicación.
Alta disponibilidad y escalado
Aumentar réplicas de un Deployment no siempre es suficiente. Cada réplica puede requerir una GPU completa y su propia carga de pesos. La estrategia dependerá del modelo, la memoria y el runtime.
- Una réplica por GPU y balanceo entre réplicas cuando cada modelo cabe en una GPU.
- Tensor parallel o pipeline parallel cuando un modelo necesita varias GPU, validando topología y rendimiento.
- Replicas separadas por modelo para evitar que modelos con perfiles distintos compitan por memoria.
- Escalado basado en cola o concurrencia, no solo en CPU.
- PodDisruptionBudget, anti-affinity y pruebas reales de reinicio y mantenimiento.
- Caché precargada o repositorio local para reducir el tiempo de recuperación.
Observabilidad y pruebas de capacidad
| Métrica | Qué nos dice | Señal de alerta |
| TTFT | Tiempo hasta el primer token | Cola, prompt largo o modelo saturado. |
| Tokens/s | Velocidad de generación | Caídas al aumentar concurrencia. |
| Concurrencia | Sesiones atendidas | Errores, timeouts o esperas largas. |
| Memoria GPU | Margen para pesos y KV cache | OOM, evictions o reinicios. |
| Utilización GPU | Aprovechamiento del acelerador | Muy baja con cola, o sostenida al 100 %. |
| Latencia total | Experiencia extremo a extremo | Gateway, red, retrieval o inferencia. |
| Errores HTTP | Salud del servicio | 429, 5xx y timeouts crecientes. |
| Tamaño de prompt | Presión de contexto | Usuarios enviando documentos completos sin control. |
Las pruebas se deben utilizar prompts y contextos representativos. Una pregunta corta desde curl no predice cómo funcionará un asistente RAG con documentos extensos y varios usuarios simultáneos.
Operación desconectada y soberanía
Si el entorno debe operar con conectividad limitada, prepararemos un flujo de suministro controlado: imágenes copiadas a un registro local, pesos descargados y validados previamente, dependencias congeladas, certificados disponibles y documentación para renovar o importar artefactos. También debemos distinguir entre ejecutar la carga sin Internet y administrar toda la plataforma de forma completamente desconectada; no son el mismo requisito y pueden implicar capacidades, licencias y procedimientos diferentes.
Errores comunes y troubleshooting
| Síntoma | Causa probable | Comprobación |
| Pod Pending | No hay GPU disponible o selector incorrecto | kubectl describe pod y capacidad del nodo. |
| CrashLoopBackOff | Modelo incompatible, argumentos erróneos u OOM | Logs del contenedor y eventos del pod. |
| CUDA no disponible | Driver o device plug-in no operativo | DaemonSet, runtime y recurso nvidia.com/gpu. |
| Descarga interminable | Token, licencia, DNS o salida bloqueada | Secret, acceso al repositorio y proxy. |
| Readiness no pasa | Carga lenta o ruta de salud incorrecta | Logs, /health e initialDelay/failureThreshold. |
| OOM con pocas peticiones | Contexto o KV cache sobredimensionados | Reducir max-model-len y medir concurrencia. |
| Respuesta lenta | Modelo grande, almacenamiento lento o cola | TTFT, tokens/s, GPU y latencia de caché. |
| Servicio inaccesible | DNS, ingress, firewall o Service mal definido | Endpoints, NetworkPolicy y ruta completa. |
¿Cuándo no elegir esta arquitectura?
- Si nuestra demanda es muy variable y no justifica mantener GPU propia.
- Si necesitamos modelos propietarios disponibles únicamente como servicio cloud.
- Si el equipo no puede operar Kubernetes, GPU, seguridad y observabilidad de forma sostenida.
- Si el objetivo es una prueba rápida y una VM aislada cubre el caso.
- Si no existe un requisito real de latencia, soberanía o integración local que compense la complejidad.
La decisión no es local contra cloud como si fueran opciones excluyentes. Muchas organizaciones terminarán con un enfoque híbrido: modelos locales para información sensible o baja latencia y servicios cloud para capacidades específicas, picos de demanda o modelos que no pueden alojar por sí mismas.
Conclusión
En el artículo anterior demostramos que un Dell Pro Max GB10 se puede convertir en un laboratorio de inferencia muy capaz con vLLM. Con Azure Local damos el siguiente paso: transformamos ese patrón técnico en una plataforma que puede integrarse con la infraestructura, la red, el almacenamiento y el gobierno de una organización.
La pieza clave es separar responsabilidades. Azure Local aporta la base híbrida; AKS habilitado por Azure Arc organiza la ejecución; la GPU acelera la inferencia; vLLM sirve el modelo; y la capa de acceso protege y gobierna el consumo. Cuando cada capa tiene límites y propietarios claros, la IA local deja de ser un experimento conectado a una GPU y empieza a comportarse como un servicio de plataforma.
Mi recomendación es avanzar por etapas: primero un modelo y un caso de uso medible, después seguridad y observabilidad, y finalmente alta disponibilidad y automatización. Y, como siempre, probadlo primero en laboratorio antes de llevarlo a producción.
Saludos, nos vemos en el próximo artículo.